딥시크가 그렇게 좋은지 알아봅시다

최근 한 학우로부터 이런 이야기를 듣게 되었습니다.
딥시크는 타 AI 서비스 대비 가격이 싸다. 근데 성능도 좋다.
필자 입장에서 중국산이라는 점 때문에 사용하기 꺼려지는 AI 서비스였는데, 한번 얼마나 가성비 좋은 AI인지 살펴보겠습니다.
딥시크란?
딥시크(DeepSeek)는 중국의 헤지펀드 환팡퀀트(幻方量化)가 세운 인공지능(AI) 스타트업입니다. 2025년 1월, GPT-4에 필적하는 고성능의 대규모언어모델(LLM) ‘딥시크-R1’을 개발하며 글로벌 AI 시장에 큰 반향을 일으켰습니다. - 출처: https://www.igloo.co.kr/security-information/%EB%B3%B4%EC%95%88-101-%EB%94%A5%EC%8B%9C%ED%81%ACdeepseek%EB%9E%80-%EB%AC%B4%EC%97%87%EC%9D%B8%EA%B0%80%EC%9A%94/
딥시크의 소개로 얼추 어떤 회사인지는 알 수 있을 것 같습니다. 그렇다면 어떻게 AI를 만들고 있는지, 다른 AI회사와 차이점을 살펴보겠습니다.
DeepSeek-V4.1-Flash(이하 V4.1 Flash)
가장 최근에 나온 모델은 9월 10일에 소개된 V4.1 Flash입니다. 이름 그대로 작고 빠른 모델이며, MoE 구조와 Causal Encoder–Decoder라는 비대칭 구조를 사용합니다.
MoE 구조와 Causal Encoder-Decoder 비대칭 구조
여기서 MoE 구조와 Causal Encoder–Decoder 비대칭 구조에 대해 간략히 설명하고 넘어가보겠습니다.
MoE 구조는 사용자의 프롬프트에 따라 모델 내부의 특정 전문가 신경망들에게 라우터로 전달해주는 구조입니다.
그래서 한 모델이 가진 지식 파라미터 대비 극히 일부의 파라미터로 해결할 수 있다는 장점이 있습니다.
하지만 단점으로는 특정 신경망들에게 부하가 집중되는 문제가 있어서 적절히 관리해야 합니다.
다음으로 Causal Encoder-Decoder 비대칭 구조입니다. 이 구조는 간단하게 설명하자면, 인코더와 디코더에 사용하는 파라미터의 수를 비대칭으로 둔다고 생각하면 됩니다.
여기서는 입력에 파라미터를 적게 두는데요.
이전 V4 Flash가 입출력에 각각 13B(B=10억) 파라미터를 두는 것에서 조정되어 현재 V4.1에서는 입력 처리에 8B, 출력 생성에 16B를 두고 있습니다.
이는 입력 처리 단계에서 많은 코드를 전달하는 에이전트 특성상 입력 처리 비용을 줄이게 됩니다.
AI 모델 평가(AA, Artificial Analysis)
각 AI회사마다 자신만의 평가기준을 내세워 자신의 AI가 더 좋다는 홍보를 하는데요. 이렇기 때문에 AI 모델에 대한 독립적 평가 사이트인 AA에서 측정한 자료를 살펴보겠습니다. https://artificialanalysis.ai/ko/models/deepseek-v4-1-flash
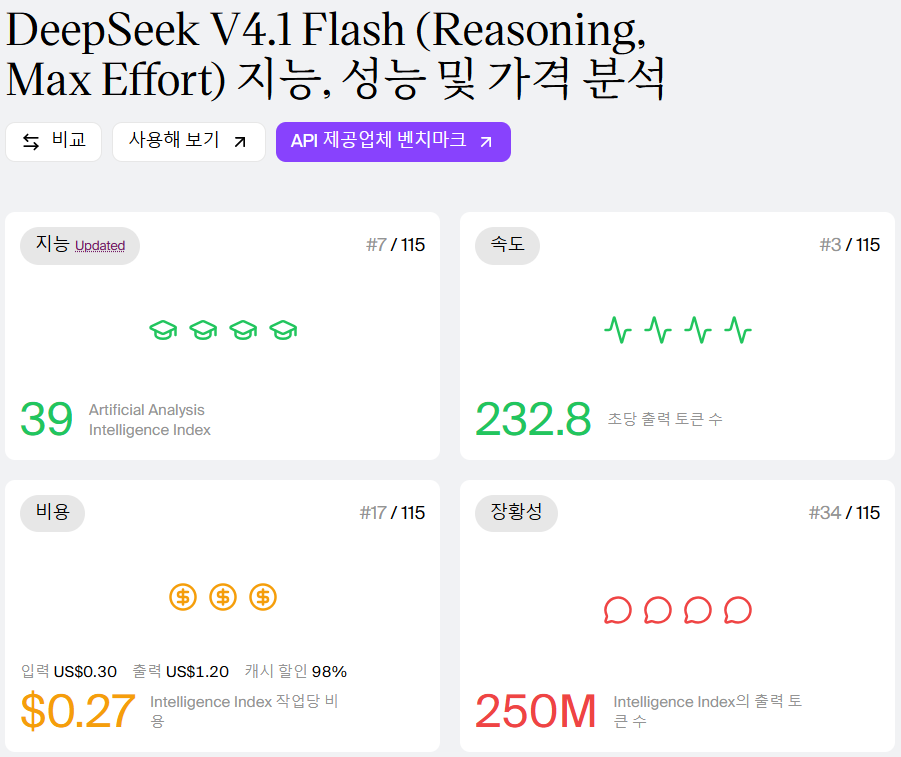
2026년 9월 25일 기준, V4.1 Flash의 최대 추론 설정은 AA 지능 지수에서 39점을 기록했습니다. 해당 페이지의 비교 대상인 유사 크기의 오픈 웨이트 모델 중앙값은 18점입니다. 출력 속도도 초당 약 233토큰으로, 성능과 생성 속도 모두 경쟁력 있는 모습을 보여줍니다.
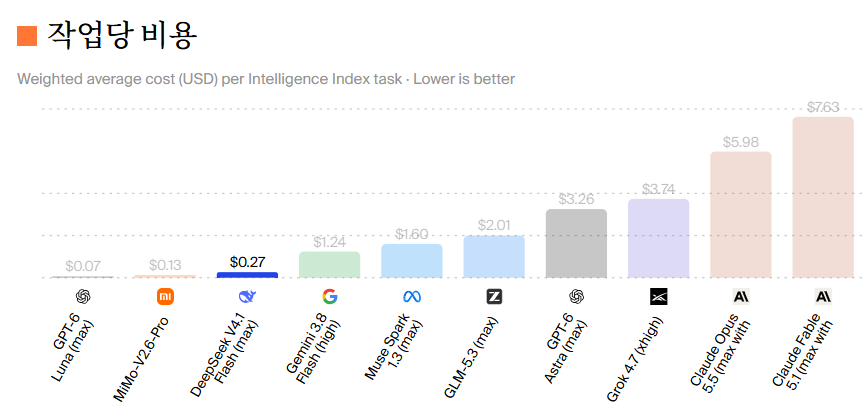
가성비를 판단할 때는 토큰 단가와 함께 실제 평가에 사용한 비용도 봐야 합니다. AA에서 측정한 V4.1 Flash의 평가 작업당 가중평균 비용은 약 0.27달러입니다. 이는 여러 벤치마크 과제를 수행하는 데 든 비용을 종합한 수치입니다.
하지만 평가 과정에서 생성한 토큰은 총 2억 5천만 개로, 중앙값인 1억 4천만 개보다 많았습니다. 토큰 단가가 저렴해도 생성량이 늘면 총비용은 커질 수 있지만, 이미 토큰 생성량이 반영되어 저 정도 가격에 형성된다는 것을 알 수 있습니다.
이 결과를 보면 V4.1 Flash는 성능과 비용을 함께 고려할 때 사용할 만한 모델이라는 생각이 듭니다. 혹시 단순한 코드 작업에 쓰는 AI가 아깝다면 이런 선택지는 어떨까요?
V4.1 Flash의 가격 비교
그렇다면 이전에는 한 작업 당 비용으로 봤는데, 이번에는 V4.1 Flash의 토큰당 가격을 보겠습니다.(참고로 딥시크는 api 토큰 비용만 있으며, 구독제로 운영하지 않습니다.)
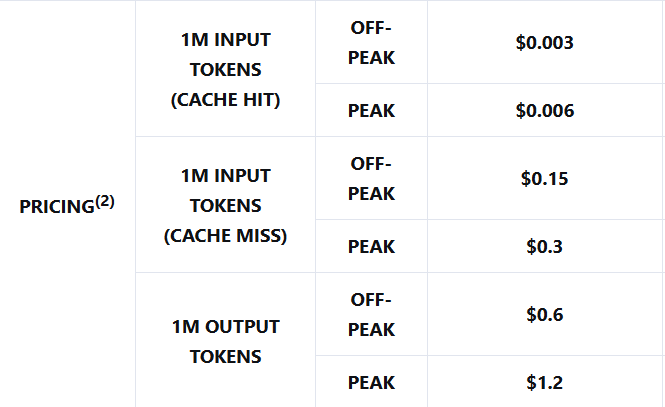
여기서 OFF-PEAK과 PEAK의 차이는 피크타임이 아닌가 피크타임인가의 차이인데요. 실제 DeepSeek API 문서에서는 평일이며 중국 공휴일이 아닌 날
UTC 01:00 ~ 04:00, 06:00 ~ 10:00으로, 한국시간 기준 오전 10시 ~ 오후 1시, 오후 3시 ~ 오후 7시로 어떻게 보면 사실상 일하는 시간에는 피크타임으로 2배의 요금이 적용됩니다.
100만 토큰 기준으로 입력 토큰이 캐시에 있냐 없냐에 따라 가격이 다르며, 모든 토큰은 100만 토큰을 기준으로 위와 같이 가격이 정해져있음을 알 수 있습니다.
그렇다면 GPT-6 Sol과 Claude Opus 5.5의 api 토큰 가격은 어떻게 될까요?
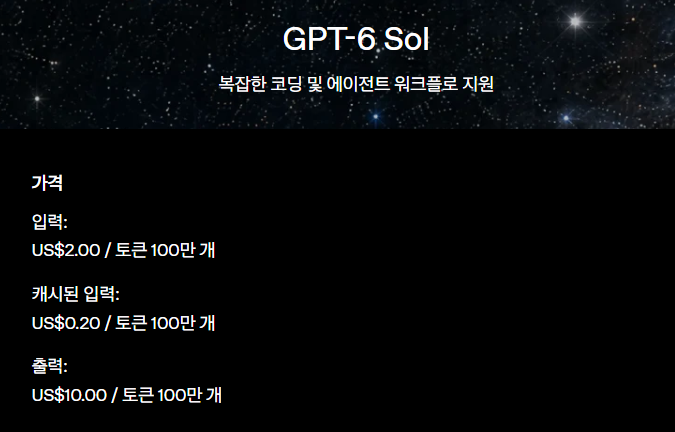
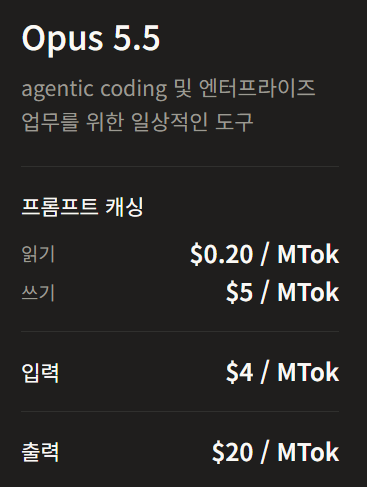
각각 살펴보면 100만 토큰 당 입력은 2 ~ 4$, 출력은 10 ~ 20$로 나옴을 알 수 있습니다.
그래서 딥시크와 비교해보면 피크 시간대에 사용해도 두 모델보다 7~17배 저렴한 것을 알 수 있습니다.
마무리
이렇게 해서 딥시크에 대해 살펴봤습니다. 최근 GPT의 Astra도 출시한 만큼, AI의 퀄리티가 높아지고, 점점 더 어려운 문제들을 해결하고 있는데요.
우리 일상의 어려운 문제들을 해결해주는 지금, 오히려 가격이 저렴한 모델을 사용해보는 것은 어떨지 한번 제안해보고자 합니다.